

[2026年02月16日] 問題集お試しセットDP-700日本語テストエンジントレーニング問題集には112問あります
Microsoft DP-700日本語問題集で100%カバー率リアル試験問題
質問 # 66
注: この問題は、同じシナリオを提示する一連の問題の一部です。一連の問題にはそれぞれ、定められた目標を満たす可能性のある独自の解答が含まれています。問題セットによっては、複数の正解が存在する場合もあれば、正解がない場合もあります。
このセクションの質問に回答した後は、その質問に戻ることはできません。そのため、これらの質問はレビュー画面に表示されません。
KQLデータベースの「Bike_Location」というテーブルにデータをロードするFabricイベントストリームがあります。このテーブルには以下の列が含まれています。
バイクポイントID
通り
近所
自転車禁止
空のドックなし
タイムスタンプ
データを利用できるようにするには、変換とフィルターロジックを適用する必要があります。ソリューションは、No_Bikes が 15 以上の場合に、Sands End という地区のデータを返す必要があります。結果は No_Bikes の昇順で並べる必要があります。
解決策: 次のコード セグメントを使用します。
これは目標を満たしていますか?
- A. いいえ
- B. はい
正解:A
解説:
This code does not meet the goal because it uses order by, which is not valid in KQL. The correct term in KQL is sort by.
Correct code should look like:
質問 # 67
ホットスポット
DW1 という名前のウェアハウスを含む Fabric ワークスペースがあります。DW1 には次のテーブルと列が含まれています。
すべての注文数量を年別および製品別に集計した値を表示する出力を作成する必要があります。結果には、すべての製品の年別注文数量の集計を含める必要があります。
コードをどのように完成させるべきですか? 回答するには、回答エリアで適切なオプションを選択してください。
注意: 正しい選択ごとに 1 ポイントが付与されます。
正解:
解説:
質問 # 68
過去 1 週間、正常に実行されている Notebook1 という名前の Fabric ノートブックがあります。
最後の実行中に、Notebook1 は 9 つのジョブを実行しました。
ジョブをタイムライン チャートで表示する必要があります。
何を使うべきでしょうか?
- A. アプリケーション実行からのジョブ履歴
- B. リアルタイムハブ
- C. アプリケーション実行の詳細からの実行シリーズ
- D. 監視ハブ
- E. Spark 履歴サーバー
正解:E
解説:
The run series from the details of the application run is the most detailed and relevant feature for visualizing job execution in a timeline format, making it the correct choice for this scenario. It provides an intuitive way to analyze job execution patterns and improve the efficiency of the notebook.
質問 # 69
ワークスペースに MasterNotebookl という名前の Fabric ノートブックを構築しています。MasterNotebookl には次のコードが含まれています。
ノートブックが次の順序で実行されることを確認する必要があります。
1. ノートブック_03
2. ノートブック.Ol
3. ノートブック_02
実行すべき2つのアクションはどれですか? それぞれの正解は解決策の一部を示しています。注:正解1つにつき1ポイント獲得できます。
- A. 有向非巡回グラフ (DAG) 定義を 3 つの個別の定義に分割します。
- B. Note book k_02 の実行に依存関係を追加します。
- C. Notebook_03 の宣言を有向非巡回グラフ (DAG) 定義の先頭に移動します。
- D. 同時実行性を 3 に変更します。
- E. Notebook_03 の実行に依存関係を追加します。
- F. Notebook_02 の宣言を有向非巡回グラフ (DAG) 定義の一番下に移動します。
正解:B、C
質問 # 70
Workspace1 という名前の Fabric ワークスペースがあり、そこには Job1 という名前の Apache Spark ジョブ定義が含まれています。
パブリック インターネット アクセスが無効になっている Source1 という名前の Azure SQL データベースがあります。
Job1 が Source1 のデータにアクセスできることを確認する必要があります。
何を創造すべきでしょうか?
- A. データ管理ゲートウェイ
- B. マネージドプライベートエンドポイント
- C. オンプレミスのデータゲートウェイ
- D. 統合ランタイム
正解:B
解説:
To allow Job1 in Workspace1 to access an Azure SQL database (Source1) with public internet access disabled, you need to create a managed private endpoint. A managed private endpoint is a secure, private connection that enables services like Fabric (or other Azure services) to access resources such as databases, storage accounts, or other services within a virtual network (VNet) without requiring public internet access.
This approach maintains the security and integrity of your data while enabling access to the Azure SQL database.
質問 # 71
ホットスポット
EventStream1 という名前のイベント ストリームを含む Fabric ワークスペースがあります。
EventStream1 変換が失敗することがわかります。
次のエラー情報を見つける必要があります。
発生時刻を含むエラーの詳細
エラーの総数
何を使うべきでしょうか? 回答するには、回答エリアで適切なオプションを選択してください。
注意: 正しい選択ごとに 1 ポイントが付与されます。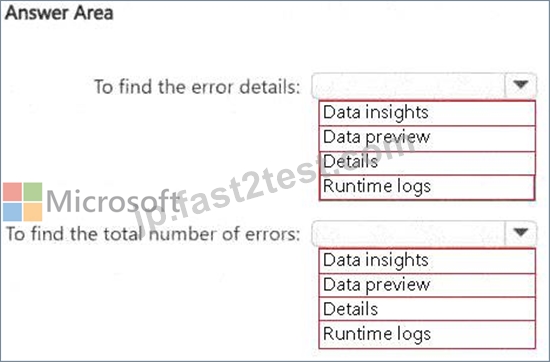
正解:
解説:
Explanation:
質問 # 72
注: この問題は、同じシナリオを提示する一連の問題の一部です。一連の問題にはそれぞれ、定められた目標を満たす可能性のある独自の解答が含まれています。問題セットによっては、複数の正解が存在する場合もあれば、正解がない場合もあります。
このセクションの質問に回答した後は、その質問に戻ることはできません。そのため、これらの質問はレビュー画面に表示されません。
StreamとReferenceという2つのテーブルを含むKQLデータベースがあります。Streamには、次の形式のストリーミングデータが含まれています。
参照には次の形式の参照データが含まれます。
どちらのテーブルにも数百万の行が含まれています。
次の KQL クエリセットがあります。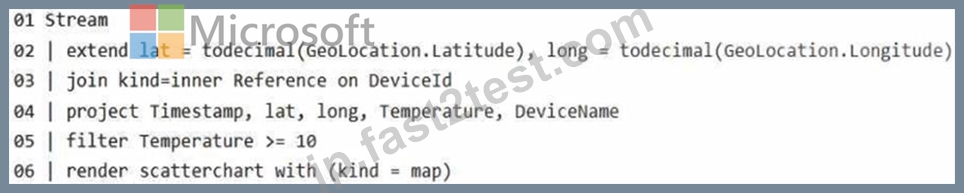
KQL クエリセットの実行にかかる時間を短縮する必要があります。
解決策: プロジェクトを変更して拡張します。
これは目標を満たしていますか?
- A. いいえ
- B. はい
正解:A
解説:
Using extend retains all columns in the table, potentially increasing the size of the output unnecessarily. project is more efficient because it selects only the required columns.
質問 # 73
Warehouse1 という名前の倉庫を含む Fabric ワークスペースがあります。
Warehouse1 で、次のステートメントを実行して DimCustomer という名前のテーブルを作成します。
Customerkey 列を DimCustomer テーブルの主キーとして設定する必要があります。
どの 3 つのコード セグメントを順番に実行する必要がありますか? 回答するには、コード セグメントのリストから適切なコード セグメントを回答領域に移動し、正しい順序に並べます。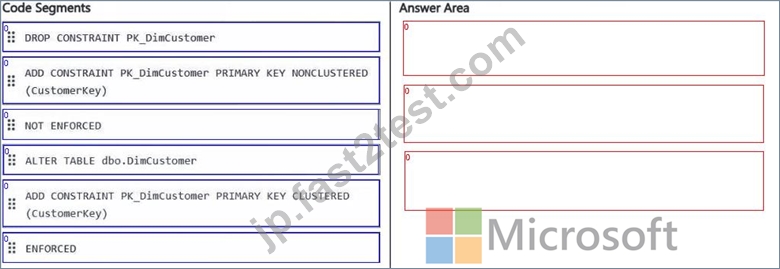
正解:
解説: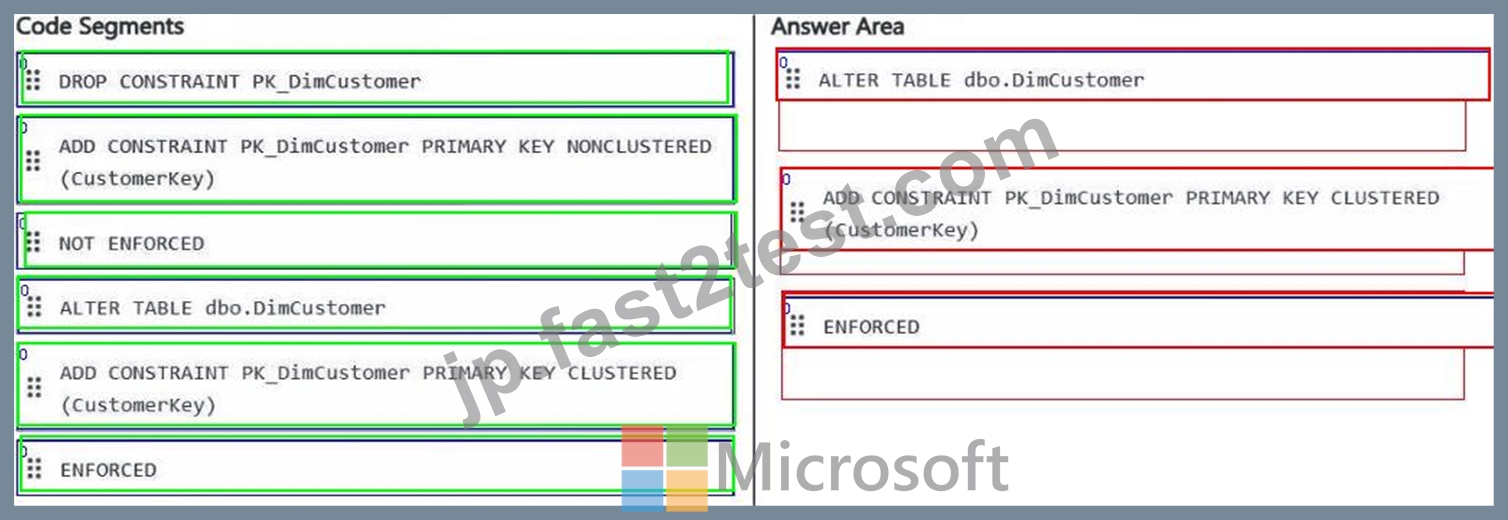
質問 # 74
過去 1 週間、正常に実行されている Notebook1 という名前の Fabric ノートブックがあります。
最後の実行中に、Notebook1 は 9 つのジョブを実行しました。
ジョブをタイムライン チャートで表示する必要があります。
何を使うべきでしょうか?
- A. アプリケーション実行からのジョブ履歴
- B. アプリケーション実行の詳細からの実行シリーズ
- C. Spark 履歴サーバー
- D. リアルタイムハブ
- E. 監視ハブ
正解:D
解説:
The run series from the details of the application run is the most detailed and relevant feature for visualizing job execution in a timeline format, making it the correct choice for this scenario. It provides an intuitive way to analyze job execution patterns and improve the efficiency of the notebook.
質問 # 75
Eventstream1 という名前のイベントストリームを含む Fabric ワークスペースがあります。Eventstream1 は、イベントストリーム処理を使用して温度センサーからのデータを処理した後、そのデータをレイクハウスに保存します。
温度の標準偏差を含めるには、Eventstream1 を変更する必要があります。
Eventstream1 ロジックに含める必要がある変換演算子はどれですか?
- A. 集計
- B. 展開
- C. 結合
- D. グループ化
正解:A
解説:
To compute the standard deviation of the temperature from the thermal sensor data, you would use the Aggregate transform operator in Eventstream1. The Aggregate operator allows you to apply functions like sum, average, count, and statistical functions like standard deviation across a group of rows or events. This operator is ideal for operations that require summarizing or computing statistics over a dataset, such as calculating the standard deviation.
質問 # 76
Workspace1 という Fabric ワークスペースがあり、その中に Warehouse2 というウェアハウスがあります。データアナリストのチームは Workspace1 への閲覧者ロールアクセス権を持っています。次のステートメントを実行してテーブルを作成します。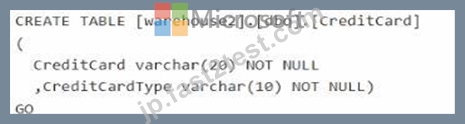
チームが Creditcard 属性の最初の 2 文字と最後の 4 文字のみを表示できるようにする必要があります。
この文をどのように完成させるべきでしょうか? 回答するには、回答エリアで適切なオプションを選択してください。
注意: 正しい選択ごとに 1 ポイントが付与されます。
正解:
解説:
Explanation: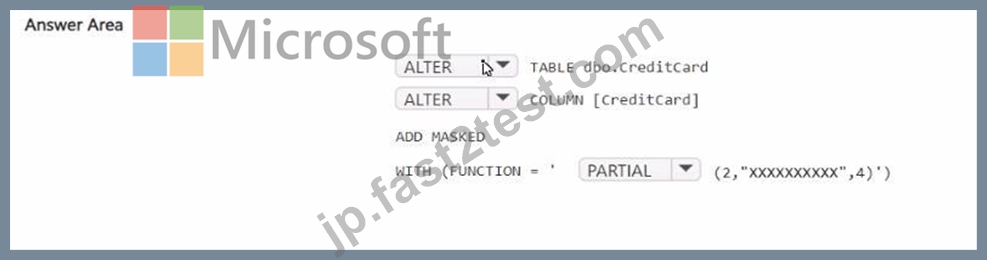
質問 # 77
Fabric があります。
Warehouse1 で、次のステートメントを実行して DimCustomer という名前のテーブルを作成します。
Customerkey 列を DimCustomer テーブルの主キーとして設定する必要があります。
どの 3 つのコード セグメントを順番に実行する必要がありますか? 回答するには、コード セグメントのリストから適切なコード セグメントを回答領域に移動し、正しい順序に並べます。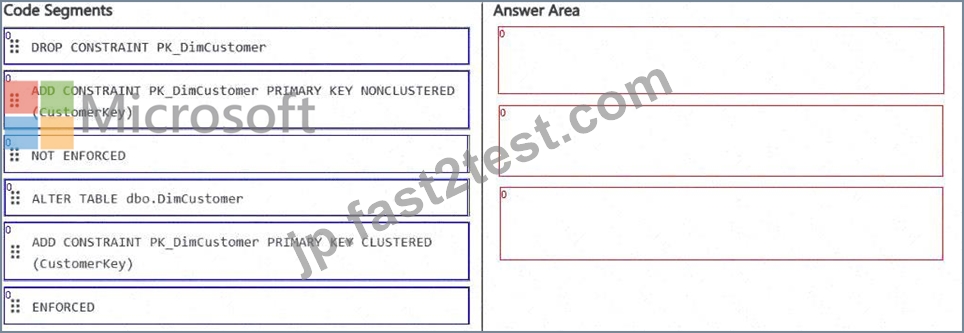
正解:
解説: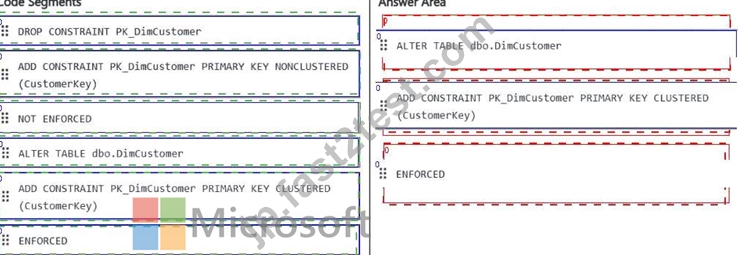
Explanation: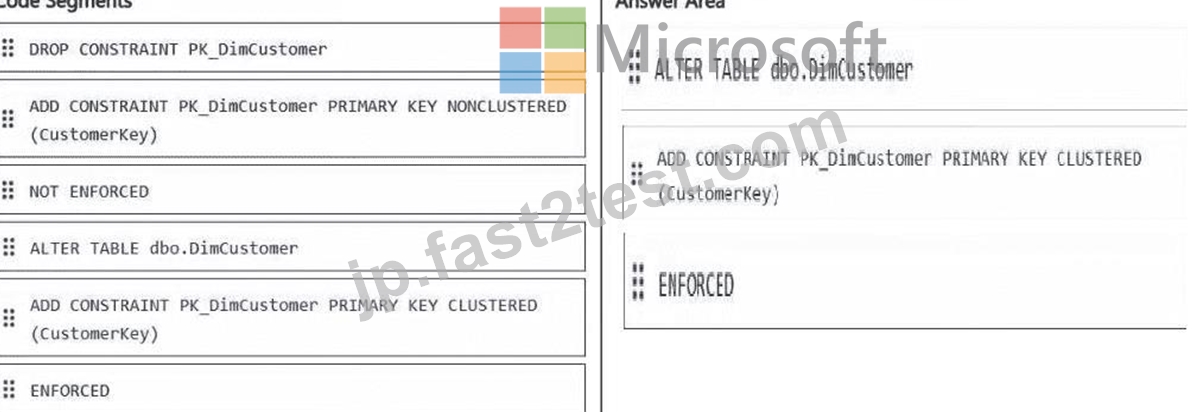
質問 # 78
注: この問題は、同じシナリオを提示する一連の問題の一部です。一連の問題にはそれぞれ、定められた目標を満たす可能性のある独自の解答が含まれています。問題セットによっては、複数の正解が存在する場合もあれば、正解がない場合もあります。
このセクションの質問に回答した後は、その質問に戻ることはできません。そのため、これらの質問はレビュー画面に表示されません。
KQLデータベースの「Bike_Location」というテーブルにデータをロードするFabricイベントストリームがあります。このテーブルには以下の列が含まれています。
バイクポイントID
通り
近所
自転車禁止
空のドックなし
タイムスタンプ
データを利用できるようにするには、変換とフィルターロジックを適用する必要があります。ソリューションは、No_Bikes が 15 以上の場合に、Sands End という地区のデータを返す必要があります。結果は No_Bikes の昇順で並べる必要があります。
解決策: 次のコード セグメントを使用します。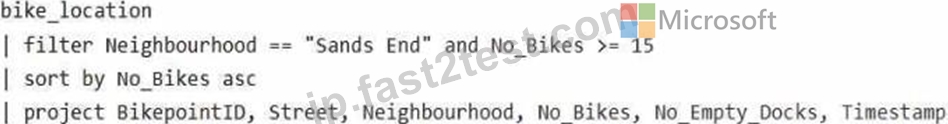
これは目標を満たしていますか?
- A. はい
- B. いいえ
正解:A
解説:
Filter Condition: It correctly filters rows where Neighbourhood is "Sands End" and No_Bikes is greater than or equal to 15.
Sorting: The sorting is explicitly done by No_Bikes in ascending order using sort by No_Bikes asc.
Projection: It projects the required columns (BikepointID, Street, Neighbourhood, No_Bikes, No_Empty_Docks, Timestamp), which minimizes the data returned for consumption.
質問 # 79
イベントハウスと Database1 という名前の KQL データベースを含む Fabric ワークスペースがあります。Database1 には次の内容が含まれています。
Table1という名前のテーブル
Table2という名前のテーブル
Policy1という名前の更新ポリシー
ポリシー1はTable1からTable2にデータを送信します。
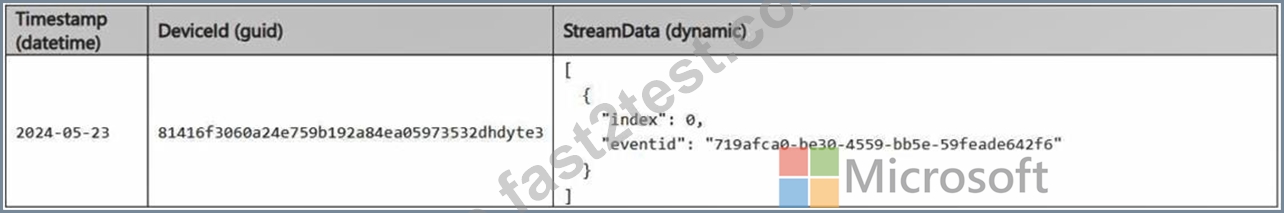
以下は表2のデータのサンプルです。
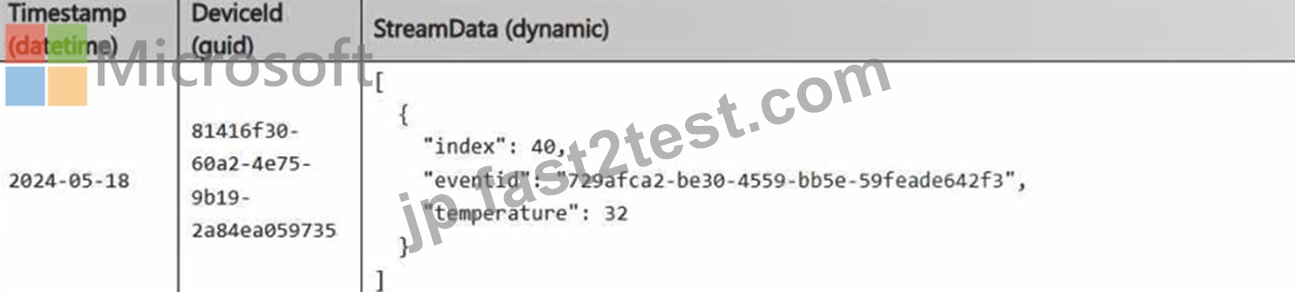
最近、Table1 に対して次のアクションが実行されました。
temperature という名前の追加要素が StreamData 列に追加されました。
Timestamp 列のデータ型が日付に変更されました。
DeviceId 列のデータ型が文字列に変更されました。
Table2 に追加のレコードをロードする予定です。
Table1 から Table2 にロードされる 2 つのレコードはどれですか。それぞれの正解は完全なソリューションを示します。
注意: 正しい選択ごとに 1 ポイントが付与されます。
- A.
- B.

- C.
- D.
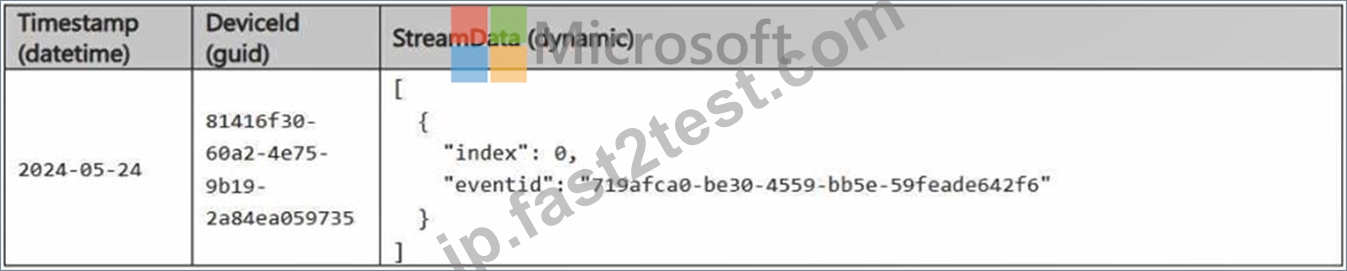
正解:B、D
解説:
Changes to Table1 Structure:
StreamData column: An additional temperature element was added.
Timestamp column: Data type changed from datetime to date.
DeviceId column: Data type changed from guid to string.
Impact of Changes:
Only records that comply with Table2's structure will load.
Records that deviate from Table2's column data types or structure will be rejected.
Record B:
Timestamp: Matches Table2 (datetime format).
DeviceId: Matches Table2 (guid format).
StreamData: Contains only the index and eventid, which matches Table2.
Accepted because it fully matches Table2's structure and data types.
Record D:
Timestamp: Matches Table2 (datetime format).
DeviceId: Matches Table2 (guid format).
StreamData: Matches Table2's structure.
Accepted because it fully matches Table2's structure and data types.
質問 # 80
あなたの会社には開発チームがあります。チームは、データ変換に使用する再利用可能なコードのPythonライブラリを作成しています。
ノートブックを使用して抽出、変換、ロード (ETL) ソリューションを開発するために使用する Fabric ワークスペース名 Workspace1 を作成します。
Workspace1 の新しいノートブックでライブラリがデフォルトで使用できることを確認する必要があります。
順番に実行する必要がある 3 つのアクションはどれですか。回答するには、適切なアクションをアクション リストから回答領域に移動し、正しい順序に並べます。
正解:
解説:
質問 # 81
Fabric 環境で次のデータ エンティティを実装しています。
エンティティ 1: レイクハウスで使用可能で、中核組織エンティティとして使用されるデータが含まれています。エンティティ 2: セマンティック モデルで使用可能で、組織の標準を満たすデータが含まれています。エンティティ 3: Microsoft Power BI レポートで使用可能で、共有および再利用できるデータが含まれています。エンティティ 4: Power BI ダッシュボードで使用可能で、経営幹部レベルの意思決定のための承認済みデータが含まれています。会社では、データに対して特定のガバナンス プロセスを実装する必要があります。
各エンティティのユースケースに基づいて、エンティティに承認バッジを適用する必要があります。
各エンティティにどのバッジを適用すべきでしょうか? 適切なバッジを正しいエンティティにドラッグしてください。各バッジは1回、複数回、または全く使用しない場合があります。コンテンツを表示するには、ペイン間の分割バーをドラッグするか、スクロールする必要がある場合があります。
注意: 正しい選択ごとに 1 ポイントが付与されます。
正解:
解説:
Explanation:
質問 # 82
Workspace1 と Workspace2 という名前の 2 つの Fabric ワークスペースがあります。
Workspace1 から Workspace2 にアイテムをデプロイする deployPipeline1 という名前の Fabric デプロイ パイプラインがあります。DeployPipeline1 には、Workspace1 内のすべてのアイテムが含まれています。
最近、Workspaces1 内のアイテムを変更しました。
ワークスペースには現在、次の表に示す項目が含まれています。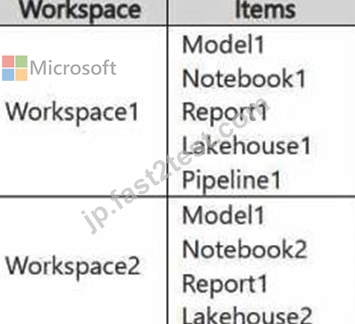
Workspace2 内のアイテムと同じ名前を持つ Workspace1 内のアイテムは現在ペアになっています。
Workspace1 のアイテムが Workspace2 の対応するアイテムを上書きするようにする必要があります。ソリューションは最小限の労力で実現する必要があります。
何をすべきでしょうか?
- A. Workspace2 内のすべての項目を削除し、deployPipeline1 を実行します。
- B. Workspace2 内の項目をバックアップし、deployPipeline1 を実行します。
- C. Workspace2 の各項目の名前を、Workspace1 の項目と同じ名前に変更します。
- D. Workspace2 内の項目を変更せずに deployPipeline1 を実行します。
正解:D
解説:
When running a deployment pipeline in Fabric, if the items in Workspace1 are paired with the corresponding items in Workspace2 (based on the same name), the deployment pipeline will automatically overwrite the existing items in Workspace2 with the modified items from Workspace1. There's no need to delete, rename, or back up items manually unless you need to keep versions. By simply running deployPipeline1, the pipeline will handle overwriting the existing items in Workspace2 based on the pairing, ensuring the latest version of the items is deployed with minimal effort.
質問 # 83
POS1 データをレイクハウス メダリオン レイヤーに取り込む方法を推奨する必要があります。
各レイヤーにはどのような推奨事項がありますか? 回答するには、回答エリアで適切なオプションを選択してください。
注意: 正しい選択ごとに 1 ポイントが付与されます。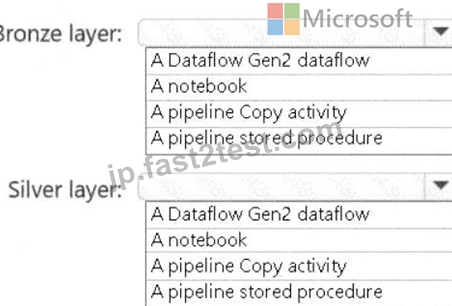
正解:
解説:
Explanation:
A screenshot of a computer Description automatically generated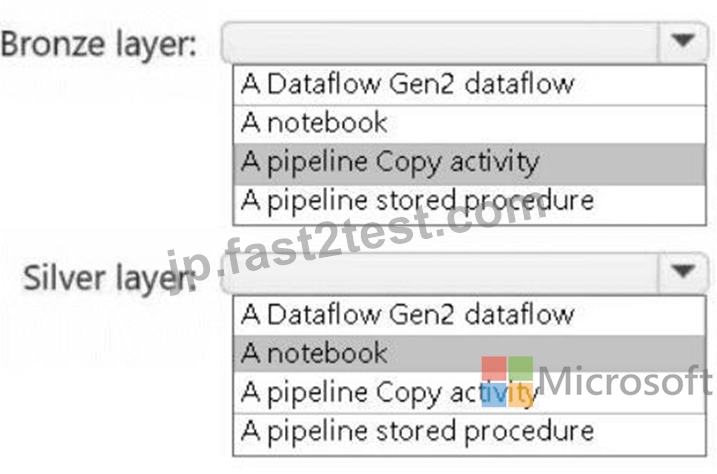
Bronze Layer: A pipeline Copy activity
The bronze layer is used to store raw, unprocessed data. The requirements specify that no transformations should be applied before landing the data in this layer. Using a pipeline Copy activity ensures minimal development effort, built-in connectors, and the ability to ingest the data directly into the Delta format in the bronze layer.
Silver Layer: A notebook
The silver layer involves extensive data cleansing (deduplication, handling missing values, and standardizing capitalization). A notebook provides the flexibility to implement complex transformations and is well-suited for this task.
質問 # 84
sa1 という名前の BLOB ストレージ アカウントを含む Azure サブスクリプションがあります。sa1 には、Filelxsv と File2.csv という 2 つのファイルが含まれています。
次の表に示す項目を含む Fabric テナントがあります。
次のアクションを実行するように Pipeline1 を構成する必要があります。
* 毎日午後 2 時に、Filel.csv を処理して、そのファイルを flhl に読み込みます。
* 毎日午後 5 時に、File2.csv を処理して、そのファイルを flhl に読み込みます。
ソリューションは開発労力を最小限に抑える必要があります。何を使用すべきでしょうか?
- A. データパイプラインスケジュール
- B. データパイプライントリガー
- C. 活性化因子
- D. ジョブ定義
正解:A
質問 # 85
......
実際にあるDP-700日本語問題集PDFで100%合格率保証付きます:https://jp.fast2test.com/DP-700J-premium-file.html